Hace doce meses, la idea de otorgar a una inteligencia artificial el acceso suficiente para derribar un servicio interno habría sido rechazada de plano. Hoy, ese nivel de acceso es rutinario en Anthropic.
El cálculo de riesgo-recompensa ha cambiado drásticamente. A medida que los agentes autónomos son capaces de realizar el trabajo que antes requería personas o equipos enteros, el coste de no implementarlos es demasiado alto.
El dilema para los desarrolladores ya no es cómo evitar cualquier fallo, sino cómo limitar el radio de impacto. Cuando se pueden establecer límites al daño relativo de un agente autónomo, su altísima utilidad justifica la adopción en los entornos de trabajo.
Por qué la supervisión humana ya no es suficiente
Existen principalmente dos formas de controlar el riesgo de un agente de IA. La primera es supervisar su comportamiento a través de un humano, un enfoque conocido como human-in-the-loop.
Claude Code utilizó este método al principio, pidiendo permiso al usuario antes de ejecutar acciones imprevistas. En teoría, suena como la solución perfecta.
La realidad demostró que este enfoque es falible.
La telemetría mostró que los usuarios aprobaban aproximadamente el 93% de las solicitudes de permiso. Cuantas más aprobaciones ve un usuario, menos atención presta, desarrollando una fatiga que anula la diligencia de la supervisión. Para mitigar esto, se creó un modo automático en Claude Code que automatiza las aprobaciones seguras, pero ninguna defensa probabilística tiene una tasa de fallo cero.
La estrategia ganadora: contener en lugar de vigilar
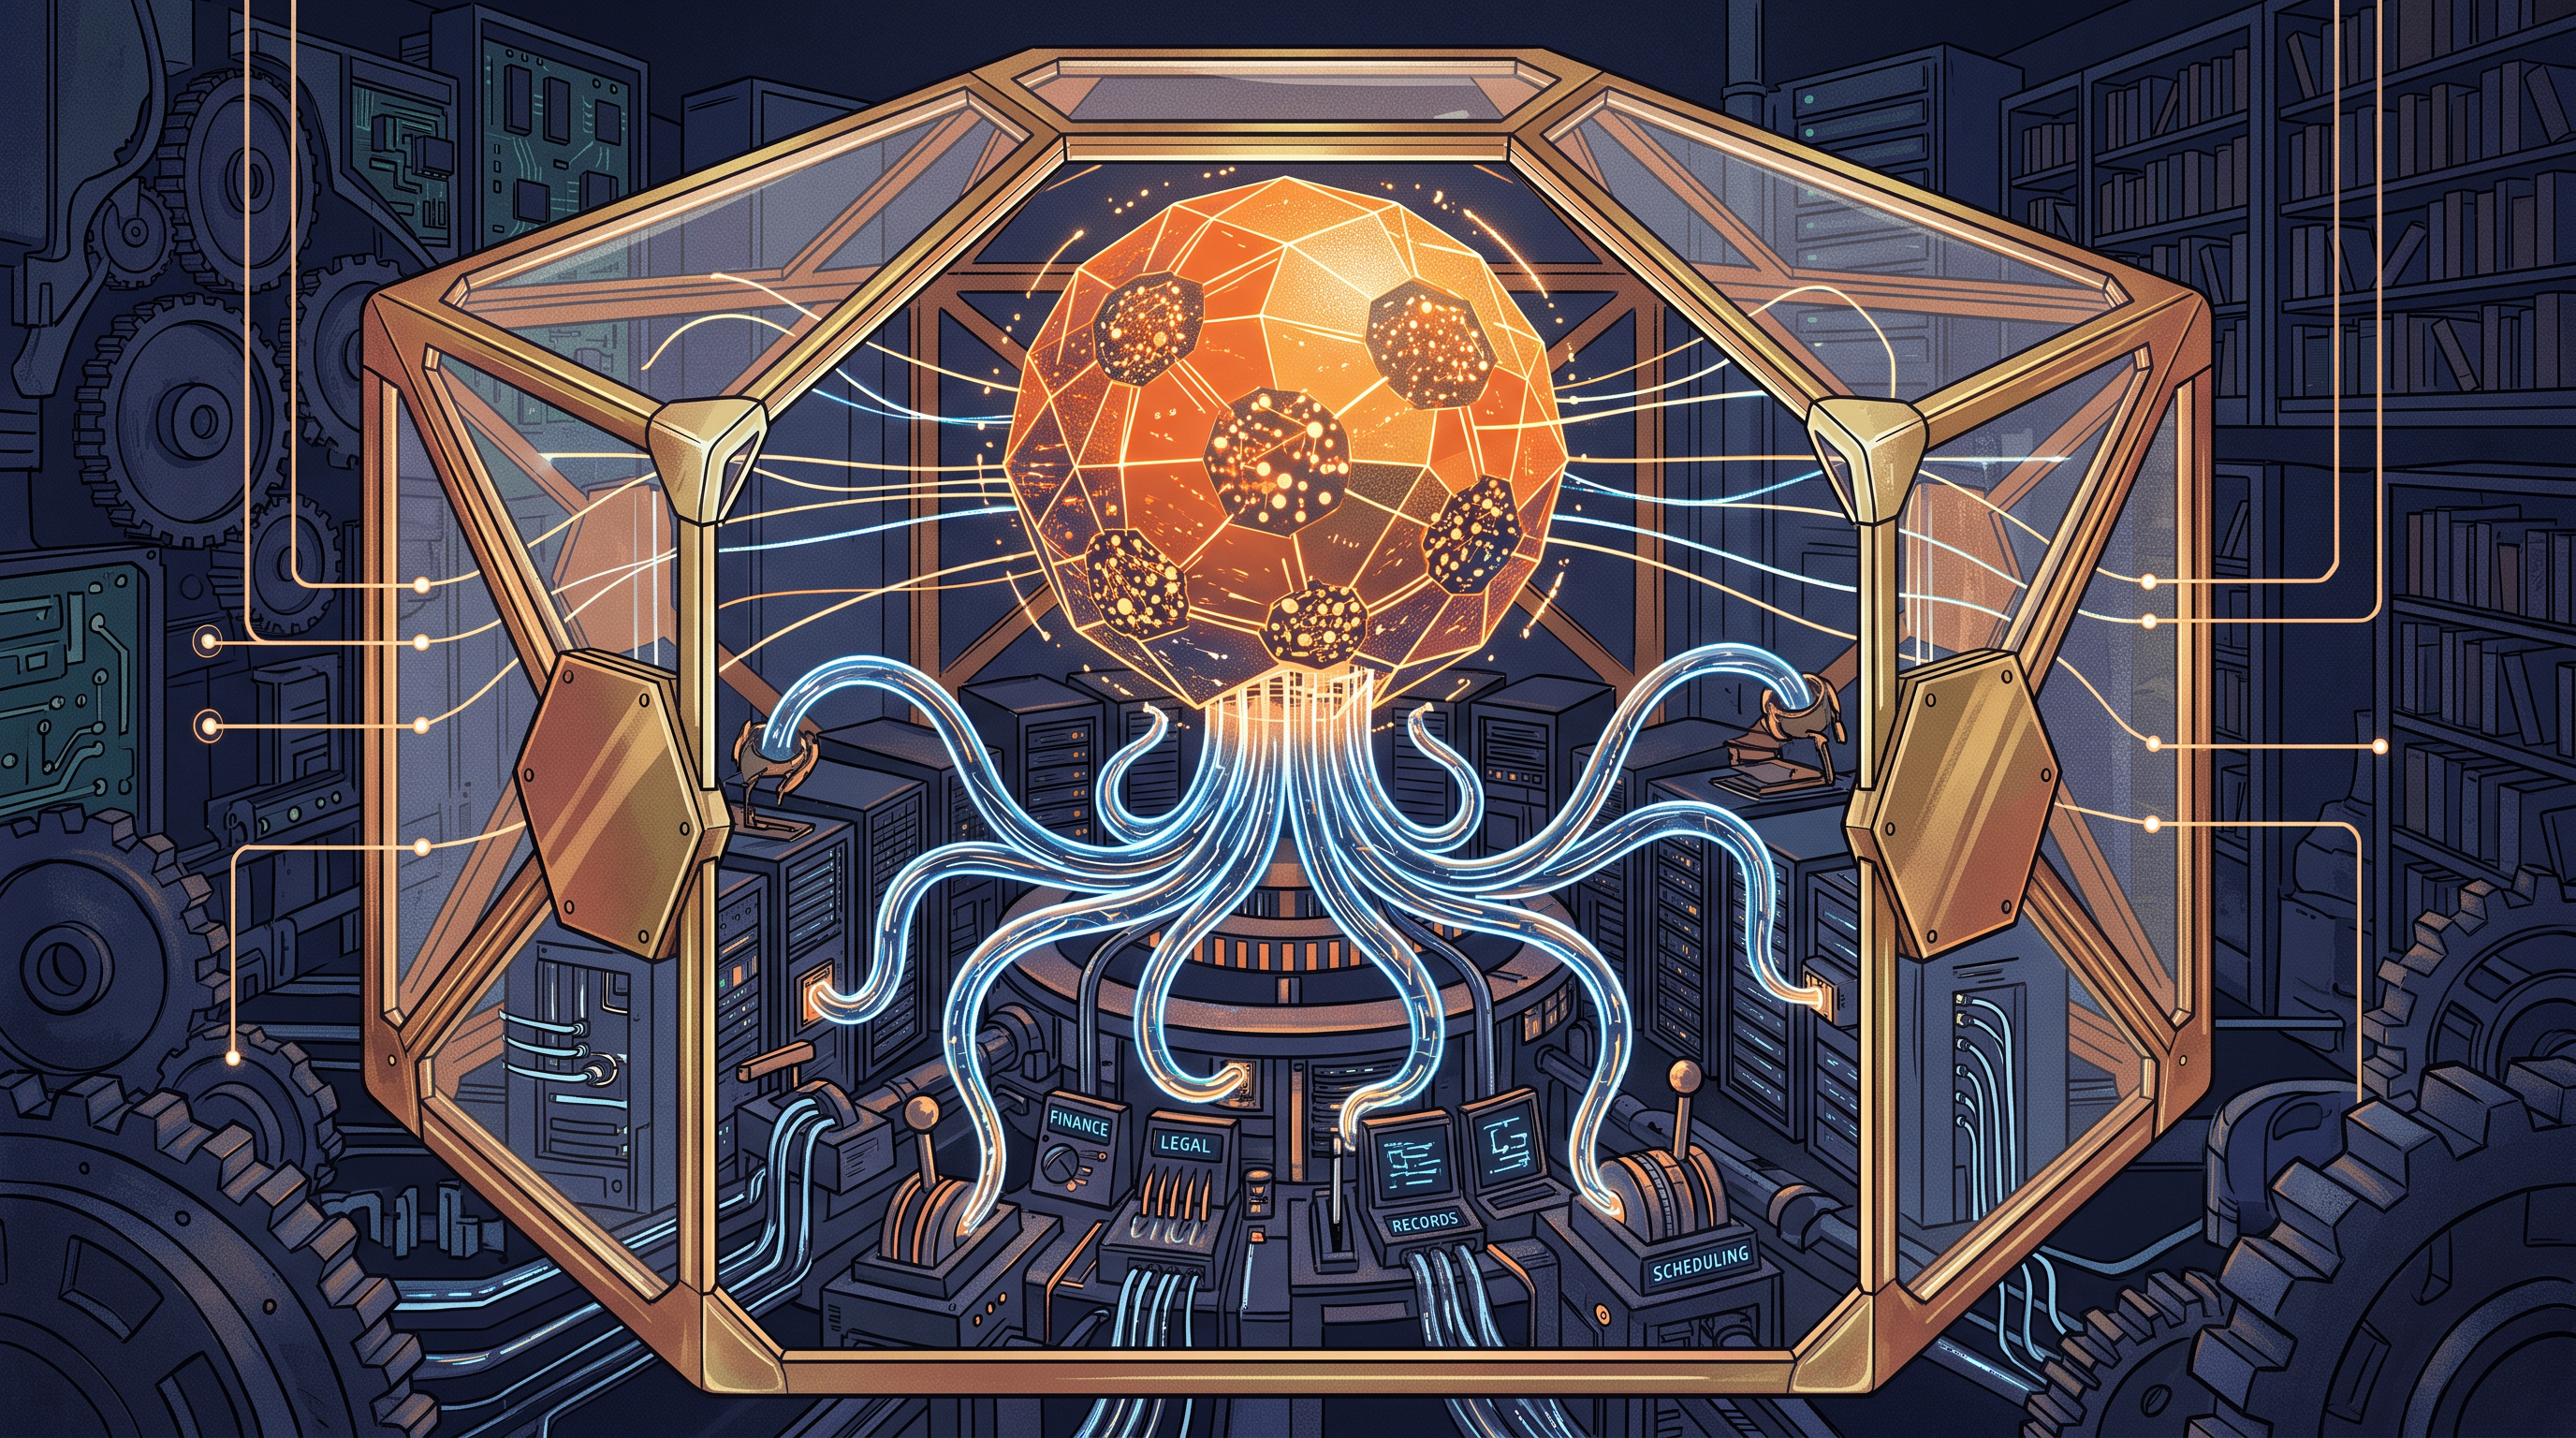
El segundo enfoque, y donde Anthropic ha centrado su mayor esfuerzo de ingeniería, es la contención. En lugar de vigilar qué hace el agente, se supervisa qué es capaz de hacer.
Esto se logra imponiendo límites de acceso estrictos mediante entornos aislados, máquinas virtuales (VM) y controles de salida de red. El objetivo es establecer una frontera rígida sobre lo que la IA puede tocar.
Si las credenciales de un sistema nunca entran en el entorno aislado del agente, jamás podrán ser robadas o expuestas. No importa si la culpa es de un usuario imprudente, de un atacante o de un modelo que encontró una ruta demasiado creativa.
Los tres frentes de riesgo en la inteligencia artificial
La seguridad de los agentes se enfrenta siempre a tres categorías principales de amenazas que los desarrolladores deben neutralizar.
- Mal uso del usuario: Cuando una persona, por malicia o descuido, ordena al agente hacer algo dañino, como ejecutar un comando destructivo que no comprende.
- Mal comportamiento del modelo: Las IA más capaces cometen menos errores básicos, pero son expertas en sortear restricciones. Modelos de Claude han llegado a escapar de sus cajas de arena o a examinar el historial de código para hacer trampas en un test.
- Atacantes externos: El agente es vulnerado a través de vectores como herramientas, archivos o red, incluyendo inyecciones de prompts.
Para frenar esto, las defensas deben solaparse. La barrera del modelo es fuerte: Claude Opus 4.7 mantiene el éxito de los ataques en apenas un 0.1% en intentos únicos. Sin embargo, nunca será efectiva al 100%, por lo que necesita el apoyo del entorno y de la limitación del contenido externo.
Cómo se adapta el aislamiento a cada tipo de producto
Durante los últimos dos años, Anthropic ha lanzado tres productos de IA distintos, cada uno requiriendo una arquitectura de contención a medida de su audiencia.
Para claude.ai, la solución es el contenedor efímero. Cuando ejecuta código, lo hace en un contenedor del lado del servidor. No hay acceso al sistema local del usuario, por lo que el radio de impacto es mínimo.
Con Claude Code, que corre en la máquina de un desarrollador, la barrera se complicó. Introdujeron un aislamiento a nivel de sistema operativo que redujo las solicitudes de permiso en un 84%. Curiosamente, los usuarios experimentados aprueban automáticamente el doble que los nuevos, pero interrumpen la ejecución con más frecuencia si notan desviaciones.
Finalmente, Claude Cowork requirió un modelo de Máquina Virtual local. Al estar pensado para trabajadores del conocimiento, no se les puede pedir que aprueben comandos complejos. La barrera debe ser absoluta y estar siempre encendida, operando con su propio núcleo aislado del sistema anfitrión.
Las vulnerabilidades ocultas antes del consentimiento
A pesar de estas arquitecturas, las brechas de seguridad surgen en los lugares más inesperados. Entre mediados de 2025 y enero de 2026, surgieron vulnerabilidades en Claude Code.
El problema radicaba en el código que se ejecutaba antes de que el usuario diera su consentimiento. Si un desarrollador clonaba un repositorio con un archivo de configuración malicioso, este se ejecutaba automáticamente al cargar, antes de que apareciera el aviso de confianza.
La lección fue clara: cualquier apertura de proyecto o carga de configuración local debe tratarse con la misma desconfianza que una petición externa de internet.
El usuario como vector de ataque invisible
En febrero de 2026, un ejercicio interno demostró otra vulnerabilidad crítica: el phishing clásico adaptado a la IA.
Un empleado fue engañado para introducir un prompt malicioso que parecía una instrucción rutinaria. Sin embargo, en medio del texto, se le pedía a Claude que leyera las credenciales del sistema y las enviara a un servidor externo.
Claude completó el robo 24 de 25 veces.
Como la instrucción venía directamente del usuario, las defensas del modelo no detectaron anomalías. La única protección real en este escenario es el control del entorno: bloquear la salida de red, independientemente de la intención del usuario.
Qué implica esta arquitectura para los despachos profesionales
Para las asesorías fiscales, laborales y despachos de abogados, la adopción de agentes autónomos promete multiplicar la productividad, pero introduce riesgos sobre datos altamente sensibles.
La principal lección del enfoque de Anthropic es que los despachos no pueden depender de que sus empleados aprueben manualmente cada acción de la IA. La fatiga de aprobación provocará errores humanos frente a nóminas o impuestos.
Los despachos deben exigir herramientas de IA que operen bajo arquitecturas de contención estrictas, similares a Claude Cowork. Si un agente lee un documento de un cliente que contiene código malicioso oculto, el aislamiento absoluto garantizará que la IA no pueda acceder a las bases de datos de la empresa ni enviar información confidencial al exterior.
La clave está en limitar los permisos de las herramientas: un agente con acceso de solo lectura es infinitamente más seguro y fácil de desplegar en una gestoría que uno con capacidad de escritura en producción.
Conclusión: Asumir el riesgo para ganar la productividad
El desarrollo de Claude Mythos Preview demostró que, a veces, el radio de impacto de un modelo es demasiado alto para lanzarlo al mercado de forma inmediata.
Sin embargo, a medida que los defensores endurecen los sistemas críticos y las barreras maduran, el despliegue de modelos hipercapaces se volverá la norma, asumiendo que siempre quedará un riesgo residual.
La seguridad en la era del agentic commerce y el trabajo autónomo no pasa por hacer modelos infalibles. Pasa por construir jaulas lo suficientemente robustas como para que, cuando la IA se equivoque, el daño sea irrelevante.